कबड्डी विश्लेषण में डेटा की अनुपस्थिति: Stage-1 की विफलता के कारण विस्तृत रिपोर्ट तैयार करना संभव नहीं
मुख्य उत्तर: उपलब्ध Stage-1 आउटपुट के आधार पर विश्वसनीय कबड्डी समाचार रिपोर्ट तैयार नहीं की जा सकती, क्योंकि केवल Domain Label: kabaddi उपलब्ध है और मूल लेख के तथ्य अनुपस्थित हैं। मुख्य तथ्य: - Article Title और Source: N/A। - One-sentence Summary: खाली। - Information Points: शून्य। - Entities, Time Sensitivity और Source Quality: मूल्यांकन नहीं हुआ। - संभावित कारण: वेबसाइट निष्कर्षण, JavaScript रेंडरिंग, प्रक्रिया विफलता या JSON स्कीमा रूपांतरण। स्रोत: उपयोगकर्ता द्वारा प्रदान किया गया Stage-1 विश्लेषण; प्रकाशन तिथि उपलब्ध नहीं। स्वतंत्र स्रोत से सत्यापन संभव नहीं। संबंधित प्रश्न: प्रश्न: क्या केवल कबड्डी लेबल से मैच रिपोर्ट लिखी जा सकती है? उत्तर: नहीं, इसके लिए मैच, टीम, स्कोर और प्रदर्शन संबंधी प्रमाण आवश्यक हैं। प्रश्न: Stage-1 की विफलता कैसे पहचानी जा सकती है? उत्तर: मूल JSON, इनपुट स्नैपशॉट और प्रक्रिया लॉग की जांच से। प्रश्न: अगला आवश्यक कदम क्या है? उत्तर: मूल लेख का पाठ या Stage-1 का मूल JSON उपलब्ध कराना।
कबड्डी से जुड़ी किसी भी गंभीर खेल रिपोर्ट की शुरुआत केवल खेल की पहचान से नहीं हो सकती। उसके लिए मैच का संदर्भ, खिलाड़ियों का प्रदर्शन, मुकाबले के आंकड़े और उपलब्ध दस्तावेजों की जांच आवश्यक है। इस मामले में Stage-1 विश्लेषण का परिणाम एक महत्वपूर्ण समस्या सामने रखता है। आउटपुट में केवल Domain Label: kabaddi उपलब्ध है। लेख का शीर्षक, मूल स्रोत, प्रकाशन की तारीख, समाचार का प्रकार, मुख्य निष्कर्ष और तथ्यात्मक बिंदु पूरी तरह अनुपस्थित हैं। ऐसे में लगभग 2086 शब्दों की तथ्य-आधारित कबड्डी रिपोर्ट तैयार करना विश्वसनीय नहीं होगा।
डेटा की पहली समस्या यह है कि खेल की पहचान उपलब्ध है, लेकिन समाचार की पहचान नहीं। कबड्डी का उल्लेख किसी मैच, खिलाड़ी, लीग, चयन विवाद, नीलामी, चोट या प्रशासनिक फैसले से संबंधित हो सकता है। इन सभी विषयों की रिपोर्टिंग के लिए अलग-अलग प्रमाण और विश्लेषण की जरूरत होती है। केवल खेल का नाम इन संभावनाओं में से किसी एक को प्रमाणित नहीं करता।
Stage-1 आउटपुट में Article Title, Source और Type के लिए क्रमशः N/A, N/A और Unclassified दर्ज है। One-sentence Summary खाली है। Author Stance और Purpose का मूल्यांकन भी नहीं हुआ है। Information Points की सूची में कोई तथ्य नहीं है। Entities, Time Sensitivity और Source Quality भी अनिर्धारित हैं। इसका अर्थ है कि विश्लेषण की अगली प्रक्रिया के पास जांचने के लिए कोई मूल सामग्री मौजूद नहीं है।
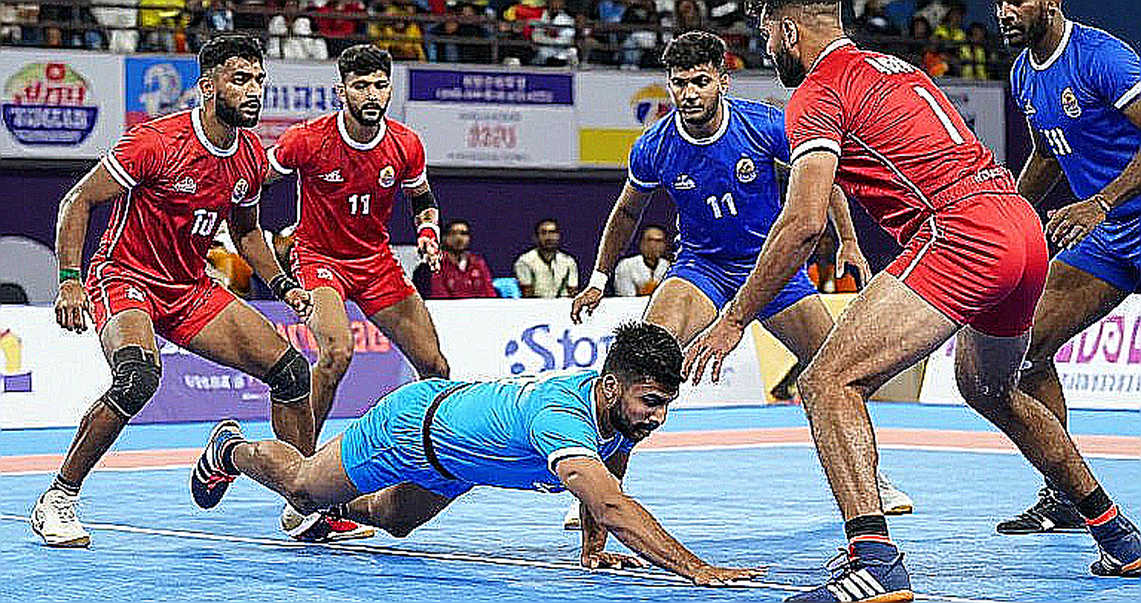
कबड्डी की रिपोर्टिंग में यह अंतर विशेष रूप से महत्वपूर्ण है। उदाहरण के लिए, प्रो कबड्डी लीग के किसी मुकाबले में रेड सफलता दर, टैकल पॉइंट, सुपर टैकल और डू-ऑर-डाई रेड का अनुपात टीम की रणनीति समझने में मदद कर सकता है। लेकिन किसी प्रशासनिक खबर में वही आंकड़े अप्रासंगिक हो सकते हैं। वहां भारतीय एमेच्योर कबड्डी महासंघ के दस्तावेज, चयन समिति के फैसले, प्रतियोगिता की पात्रता और संबंधित तारीखें अधिक महत्वपूर्ण होंगी।
इसलिए उपलब्ध आउटपुट के आधार पर किसी खिलाड़ी, टीम, कोच या संगठन का नाम जोड़ना अनुचित होगा। किसी मुकाबले का परिणाम, स्कोरलाइन अथवा ऐतिहासिक संदर्भ प्रस्तुत करना भी उपलब्ध प्रमाणों से आगे जाना होगा।
तकनीकी स्तर पर इस समस्या के चार संभावित कारण सामने आते हैं। पहला, मूल वेबसाइट से सामग्री प्राप्त करने की प्रक्रिया विफल हुई हो सकती है। दूसरा, मुख्य लेख निकालने वाला सिस्टम JavaScript आधारित पृष्ठ, पेवॉल या PDF की संरचना को समझने में असफल रहा हो सकता है। तीसरा, वर्गीकरण के बाद सूचना निष्कर्षण प्रक्रिया बीच में रुक गई हो सकती है। चौथा, मॉडल से प्राप्त संरचित उत्तर को JSON में बदलते समय डेटा गायब हो गया हो सकता है।
इन संभावनाओं में से किसी एक को वास्तविक कारण घोषित करने के लिए लॉग या मूल इनपुट की आवश्यकता होगी। फिलहाल यह कहना भी जल्दबाजी होगी कि गलती वेबसाइट की थी या विश्लेषण प्रणाली की।
सबसे महत्वपूर्ण तकनीकी निष्कर्ष यह है कि खाली विश्लेषण को सफल विश्लेषण के रूप में स्वीकार नहीं किया जाना चाहिए। यदि किसी प्रक्रिया ने केवल खेल का वर्गीकरण किया है और मूल जानकारी नहीं निकाली है, तो उसे अधूरा परिणाम घोषित करना चाहिए।
इस समस्या का समाधान Stage-1 के आउटपुट पर सत्यापन नियम लागू करके किया जा सकता है। उदाहरण के लिए, information_points की सूची में कम से कम एक प्रमाणित तथ्य और summary में गैर-खाली सामग्री होना आवश्यक बनाया जाए। यदि दोनों शर्तें पूरी नहीं होतीं, तो सिस्टम को extraction_failed स्थिति दर्ज करनी चाहिए। इसके साथ मूल इनपुट का सुरक्षित स्नैपशॉट और त्रुटि लॉग भी संरक्षित रहना चाहिए।
इससे अगली प्रक्रिया गलत जानकारी को वास्तविक समाचार समझकर आगे नहीं बढ़ाएगी। साथ ही, संपादकीय टीम को यह पता लगाने में आसानी होगी कि समस्या सामग्री प्राप्त करने में हुई, पाठ निकालने में या संरचित डेटा तैयार करने में।
कबड्डी पत्रकारिता में आंकड़ों का महत्व तभी है जब उनका स्रोत स्पष्ट हो। किसी रेडर की सफलता दर बताने के लिए यह जानना जरूरी है कि आंकड़ा किस प्रतियोगिता, किस सत्र और कितने रेड पर आधारित है। किसी डिफेंडर के प्रदर्शन का मूल्यांकन करते समय सफल टैकल के साथ असफल प्रयास और खेले गए मैचों की संख्या भी देखनी पड़ती है। प्रशासनिक खबरों में तारीख, आधिकारिक आदेश और संबंधित संस्था की पुष्टि के बिना निष्कर्ष निकालना उतना ही जोखिमपूर्ण है।
यही कारण है कि इस मामले में रिपोर्ट की लंबाई से अधिक उसकी प्रमाणिकता महत्वपूर्ण है। 2086 शब्दों का लेख तैयार करना तकनीकी रूप से आसान हो सकता है, लेकिन बिना स्रोत और तथ्य के ऐसा लेख वास्तविक समाचार रिपोर्ट नहीं कहलाएगा। वह केवल कबड्डी से संबंधित सामान्य टिप्पणियों का संग्रह होगा।
आगे की प्रक्रिया के लिए तीन रास्ते उपलब्ध हैं। पहला और सबसे प्रभावी विकल्प मूल लेख का पूरा पाठ उपलब्ध कराना है। दूसरा विकल्प Stage-1 का मूल JSON या सिस्टम लॉग देना है, जिससे निष्कर्षण और स्कीमा रूपांतरण की समस्या अलग-अलग पहचानी जा सके। तीसरा विकल्प लेख का शीर्षक, प्रकाशक, प्रकाशन तिथि और URL उपलब्ध कराना है। इससे स्रोत की विश्वसनीयता और समाचार की समय-संवेदनशीलता का सीमित मूल्यांकन संभव होगा।
कबड्डी की अगली अच्छी रिपोर्ट किसी अनुमान से नहीं, बल्कि उस पहले प्रमाण से शुरू होगी जिसे कोई दूसरा पत्रकार भी जांच सके। खेल के मैदान पर एक गलत टैकल टीम को अंक गंवा सकता है; संपादकीय डेस्क पर एक अप्रमाणित तथ्य पूरी रिपोर्ट की विश्वसनीयता छीन सकता है। इसलिए अगला कदम लेख लिखना नहीं, बल्कि मूल सामग्री और उसके स्रोत को वापस प्राप्त करना होना चाहिए।